在液氩时间投影室(liquid-argon TPC)里,电荷读出给出了径迹的形状,却给不出它沿漂移方向的位置,这个位置要由光电倍增管(PMT)看到的光来定。通常的做法是对每个事例单独做一次梯度下降拟合:假定一个位置,用光子库(photon library)算出 PMT 应有的读数,再与实测比较,反复迭代。ReconNN 是一个神经网络,它读入径迹和 PMT 上的光分布(即每个 PMT 收到的光电子数),一次前向计算就给出位置,在 A100 上比逐事例拟合快 300 倍左右。借助合作组的可微前向模型,它还可以在没有位置标签的情况下训练。这项工作是 2024 年在美日 CIDeR-ML 合作组里做的。
- ~300×比逐事例拟合快的倍数,每 100 个事例 0.06 s 对 17 s
- 1.20 对 1.19光分布的拟合残差,ReconNN 对优化器
- 8,000WCSim 模拟生产的 Slurm 作业数,2,000 个并发
逐事例拟合的代价
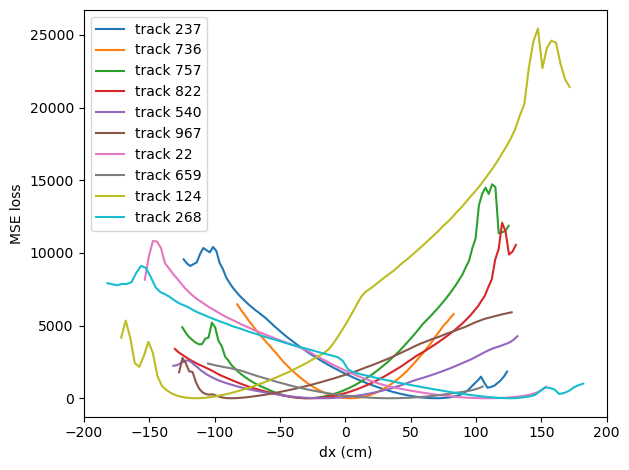
合作组的 XOptimizer 对每个事例的漂移偏移量 dx 单独拟合,先粗扫一遍,再用 Adam 迭代,最多 500 步。在 A100 上每 100 个事例约需 17 s,10 万个事例的样本要算几个小时。损失函数的形状也不友好:有些径迹的曲线不止一个极小值,因此结果依赖于优化器的设置。同一条径迹用默认设置得到的残差是 46,调过参数以后是 1.2。摊销推断(amortised inference)的思路是把这个代价在训练时一次付清,之后每个事例只需一次前向计算。
三种编码器与循环训练
每个事例是一个点云,点数不定,约 1,100 到 1,300 个,每个点是 (x, y, z, 电荷),另有一个 180 通道的 PMT 向量。点云的编码器我试了三种。第一种把径迹看成链式图,用图卷积网络(GCN)处理,有 24.5 万个参数。第二种先把径迹重采样成 400 个点,再用一维卷积神经网络(Convolutional Neural Network,CNN)加全局平均池化,有 27.9 万个参数。第三种是 MinkowskiEngine 的稀疏三维卷积网络,有 41.9 万个参数。每一种都与一个读 PMT 向量的多层感知机(MLP)融合后回归 dx,训练数据是 1 万个模拟的 ICARUS 事例。
真正起作用的是循环训练(cycle training)。每一步训练先把径迹按预测的 dx 平移,去掉移出探测器的点,再送进可微的光子库算出 PMT 应有的光分布,然后用泊松负对数似然与实测的光分布比较。光子库自定义的自动微分把梯度传回网络。这个回路里没有一步用到真实位置,因此它也可以在真实探测器数据上运行。把前向模型改成批量计算以后,损失函数的计算快了 30 倍左右;修正径迹归一化以后,也不再需要先用标签预热(warm-up)。
速度与精度
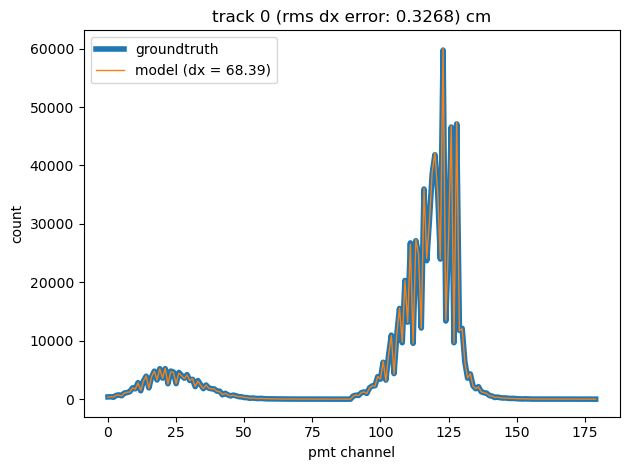
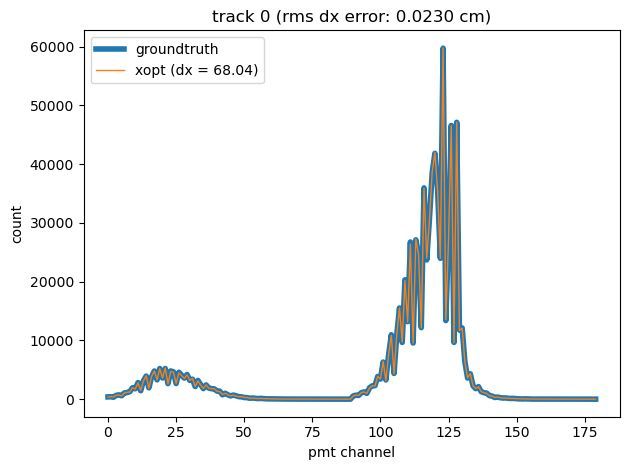
推理每 100 个事例约 0.06 s,优化器用默认设置约 17 s,快 300 倍左右;与调过参数的约 8 s 相比,快 130 倍左右。在一条典型的径迹上,循环训练的图卷积网络对光分布的拟合与优化器相当,rms 残差 1.20 对 1.19,但位置误差是 0.33 cm 对 0.023 cm。位置精度上的差距必须如实说明:用标签训练的网络在测试集上的 rms 误差是 5.14 cm,而目标是 1 mm 左右,有些径迹还差几十厘米。它目前只是一个很快的初值,还不是最终的拟合结果。
WCSim 的模拟生产
在水切伦科夫探测器上,我做的是为它的光学代理模型提供模拟数据的蒙特卡洛(Monte Carlo,MC)模拟生产。WCSim 作业以 Slurm 作业数组提交,共 8,000 个作业,2,000 个并发,每个作业 150 个事例,每个事例 20 万个光子。作业分布在 SLAC 的 S3DF,Compute Canada 的 Cedar 和 NERSC 三个集群上,生产框架是我移植到 Shifter 上的。WCSim 只用一个核,申请 8 个核的作业 CPU 利用率只有 12.5%;改成每个作业一个核以后,S3DF 每小时能产出 2,500 个文件,没有一个超时。
ReconNN 由我一个人开发,仓库里的每一次提交都是我做的,包括编码器,数据管线,循环训练的回路,以及与 XOptimizer 的对比。前向模型,光子库,玩具蒙特卡洛和 XOptimizer 是合作组已有的代码(siren-pfmatch,photonlib),我在它们的基础上开发 ReconNN。水切伦科夫探测器方面,我与 Kazuhiro Terao 共同负责计算,跑的是他的生产框架。这项工作没有发表文章,在合作组内报告过五次,其中包括在东京大学的报告。
美日 CIDeR-ML 合作组(SLAC,Kavli IPMU / 东京大学,塔夫茨大学,东京工业大学,明尼苏达大学),组织架构图上写的是「Computing (Zhe, Kazu)」。数字出自我 2024 年 8 月 8 日的总结报告,仓库里的 notebook 和 2024 年 2 到 3 月的 MC 生产报告。